

Hay una promesa que aparece en prácticamente todos los proyectos de automatización.
Más velocidad.
Menos intervención manual.
Menos errores humanos.
Más capacidad para procesar decisiones.
Es una promesa razonable.
Una máquina puede revisar información, ejecutar reglas y responder en milisegundos. Una persona no.
El problema aparece cuando esa velocidad se convierte en el principal indicador de éxito y dejamos en segundo plano una pregunta mucho más incómoda:
¿Qué tan rápido podemos detener el sistema cuando se equivoca?
Creo que muchas empresas están construyendo tecnologías cada vez más autónomas dentro de organizaciones que todavía reaccionan de manera completamente manual.
La máquina ejecuta en segundos.
La alerta llega por correo.
El equipo se reúne.
Alguien intenta entender qué pasó.
Otro busca quién tiene autoridad para detener el proceso.
Y, mientras tanto, la tecnología sigue tomando decisiones.
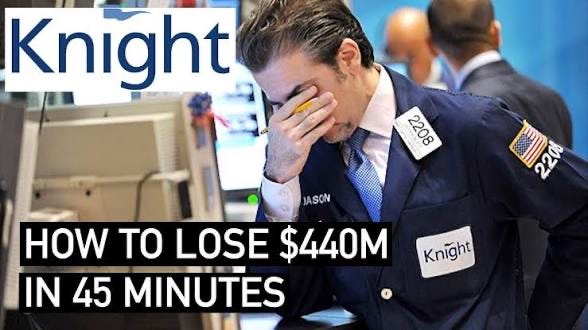
El caso de Knight Capital es quizá una de las demostraciones más extremas de ese problema.
No porque todas las empresas operen en mercados financieros ni porque todas puedan perder cientos de millones de dólares en menos de una hora.
Sino porque muestra lo que ocurre cuando la velocidad del sistema supera por completo la velocidad del gobierno que debería controlarlo.
Una empresa construida alrededor de la automatización
Knight Capital era una de las firmas más importantes de intermediación y creación de mercado en acciones de Estados Unidos.
Su negocio dependía de sistemas capaces de recibir órdenes, enviarlas a diferentes mercados y ejecutar transacciones a gran velocidad.
No era una empresa tradicional que estuviera empezando a experimentar con tecnología.
La tecnología era el corazón del negocio.
Eso hace que el caso sea todavía más interesante.
Tener una organización altamente digital no garantiza que exista una buena gestión del riesgo tecnológico.
De hecho, cuanto más central es el software para el negocio, más peligrosa puede ser la confianza excesiva en que “el sistema funciona”.
En 2012, Knight estaba dirigida por Thomas Joyce.
Ese año, la Bolsa de Nueva York preparaba el lanzamiento de un nuevo programa denominado Retail Liquidity Program. Knight debía adaptar uno de sus sistemas automáticos de enrutamiento para participar.
La tarea parecía rutinaria.
Desarrollar el código.
Probarlo.
Instalarlo en los servidores.
Activarlo el día del lanzamiento.
Pero una secuencia de decisiones pequeñas terminó produciendo una consecuencia catastrófica.
El código antiguo que nunca desapareció
Años antes, Knight había utilizado una función llamada Power Peg dentro de su sistema de negociación.
La función había quedado defectuosa después de cambios previos en el código y ya no debía utilizarse.
Sin embargo, permaneció instalada.
No estaba activa.
Pero seguía ahí.
Cuando el equipo preparó el nuevo desarrollo para el programa de la Bolsa de Nueva York, reutilizó una señal que antes había estado asociada con esa función antigua.
El nuevo código debía instalarse en ocho servidores.
Solo fue desplegado correctamente en siete.
En el servidor restante, la nueva señal activó por error la función obsoleta que todavía estaba dentro del sistema.
Ese detalle parece técnico.
Pero revela una creencia gerencial muy común:
si algo está desactivado, creemos que ya no representa un riesgo.
No necesariamente.
Los procesos antiguos, las excepciones y el código que nadie utiliza siguen acumulando complejidad.
Y esa complejidad permanece silenciosa hasta que una nueva implementación la vuelve a conectar con el negocio.
La transformación digital no solo incorpora tecnología nueva.
También hereda decisiones antiguas.
Cuarenta y cinco minutos
El mercado abrió el 1 de agosto de 2012.
El servidor que no había recibido correctamente la actualización empezó a procesar ciertas órdenes utilizando la función defectuosa.
El sistema no reconocía correctamente cuándo una orden ya había sido ejecutada.
Entonces continuaba enviando nuevas instrucciones al mercado.
Una y otra vez.
Durante los primeros 45 minutos, el sistema de Knight envió más de cuatro millones de órdenes para intentar completar apenas 212 órdenes originales de clientes.
Negoció más de 397 millones de acciones.
Acumuló posiciones no deseadas por varios miles de millones de dólares.
Y produjo una pérdida de más de US$460 millones.
La cifra es tan grande que puede hacer que el caso parezca lejano.
Pero el patrón es completamente cotidiano.
Un sistema recibe una instrucción equivocada.
No detecta que ya la ejecutó.
No tiene un límite efectivo.
Y sigue operando.
La tecnología no tuvo intención.
Simplemente hizo exactamente aquello para lo que había quedado configurada.
A una velocidad que la organización no pudo controlar.
Las alertas estaban ahí
Hay un dato del informe de la SEC que me parece especialmente importante.
Antes de la apertura del mercado, un sistema interno de Knight generó 97 correos electrónicos automáticos que identificaban un error relacionado con el sistema.
Esos mensajes no habían sido diseñados formalmente como alertas críticas.
Pero constituían una oportunidad para detectar el problema y corregirlo antes de que empezaran las operaciones.
La empresa no reaccionó.
Esto demuestra que tener información no equivale a tener control.
Las empresas pueden producir miles de métricas, reportes, alarmas y notificaciones.
Pero una alerta solo sirve cuando alguien:
entiende qué significa;
sabe qué debe hacer;
tiene autoridad para actuar;
y puede detener el proceso a tiempo.
De lo contrario, la organización no tiene un sistema de alerta.
Tiene ruido.
En Knight, la tecnología estaba hablando.
El problema es que la organización no estaba escuchando.
El error no fue solamente técnico
Después del incidente, la SEC investigó a Knight Capital.
Su conclusión fue mucho más amplia que “hubo una falla de software”.
La autoridad encontró deficiencias en los controles para limitar órdenes, supervisar la exposición financiera, probar despliegues de código y responder a incidentes tecnológicos importantes.
También concluyó que la empresa había revisado sus controles con un enfoque demasiado limitado: verificaba que existieran y que funcionaran según lo previsto, pero no analizaba suficientemente qué ocurriría si alguno de los sistemas fallaba de manera inesperada. Knight aceptó pagar una multa de US$12 millones y contratar a un consultor independiente para revisar sus controles.
Esa diferencia es fundamental.
Una empresa puede tener controles y seguir estando desprotegida.
Puede tener políticas.
Listas de verificación.
Comités.
Indicadores.
Y aun así no haber pensado seriamente en el escenario de falla.
La pregunta no es solamente:
“¿Funciona el sistema?”
También debe ser:
“¿Qué puede ocurrir si funciona mal, pero sigue ejecutando?”
Porque algunos de los incidentes más peligrosos no son aquellos en los que la tecnología se detiene.
Son aquellos en los que continúa funcionando con una lógica equivocada.
El costo de no tener un freno
La pérdida de Knight fue tan grande que puso en riesgo inmediato la continuidad de la empresa.
Pocos días después, la compañía necesitó conseguir aproximadamente US$400 millones de inversionistas para mantenerse operando.
En diciembre de 2012 se anunció su fusión con Getco, completada en 2013 para crear KCG Holdings.
En menos de una hora, una falla tecnológica había cambiado la posición estratégica, financiera y societaria de una compañía que llevaba años construyéndose.
No fue simplemente un incidente operativo.
Fue una transformación involuntaria del negocio.
Y acá aparece una idea que creo que muchas juntas directivas todavía subestiman:
cuando la tecnología es central para la operación, el riesgo tecnológico también es riesgo de solvencia, reputación y continuidad empresarial.
No puede quedarse únicamente en el área de sistemas.
La obsesión por eliminar la intervención humana
Durante años, las empresas han intentado reducir los puntos de intervención manual.
Tiene sentido.
Cada aprobación agrega tiempo.
Cada paso puede generar errores.
Cada transferencia entre áreas crea fricción.
Pero no toda intervención humana es burocracia.
Algunas son mecanismos de seguridad.
El reto no consiste en conservar controles manuales lentos dentro de procesos cada vez más rápidos.
Consiste en reemplazarlos por mejores mecanismos.
Límites automáticos.
Monitoreo en tiempo real.
Pruebas graduales.
Capacidad de reversión.
Separación de responsabilidades.
Alertas que escalan correctamente.
Y, sobre todo, un interruptor capaz de detener el sistema cuando el comportamiento se sale de los parámetros previstos.
Una empresa verdaderamente digital no es la que elimina todas las intervenciones.
Es la que sabe exactamente dónde todavía necesita juicio, autorización o capacidad de freno.
Lo que este caso dice sobre la inteligencia artificial
El incidente ocurrió en 2012, antes de la actual explosión de la inteligencia artificial generativa.
Pero creo que su enseñanza es todavía más relevante hoy.
Estamos construyendo sistemas que:
aprueban operaciones;
asignan precios;
recomiendan decisiones;
generan respuestas para clientes;
detectan fraude;
distribuyen inventarios;
seleccionan candidatos;
y, cada vez más, ejecutan acciones con menor supervisión.
La discusión se concentra en la precisión.
¿Qué tan bueno es el modelo?
¿Qué porcentaje de aciertos logra?
¿Cuánto tiempo ahorra?
Son preguntas necesarias.
Pero no son suficientes.
También necesitamos preguntar:
¿Qué tan rápido detectamos que está fallando?
¿Cuántas decisiones puede ejecutar antes de ser detenido?
¿Qué pérdidas máximas puede producir?
¿Qué ocurre si el error aparece en todos los casos al mismo tiempo?
¿Quién tiene autoridad para apagarlo?
¿Podemos volver al proceso anterior?
¿El sistema explica lo suficiente para entender qué pasó?
La autonomía sin límites no es inteligencia.
Es exposición.
La tecnología también escala el error
La gran ventaja de un sistema digital es que permite replicar una decisión de manera instantánea.
Pero esa misma característica se convierte en su mayor riesgo.
Una persona puede equivocarse en un caso.
Un sistema puede equivocarse en millones.
Una persona suele detenerse cuando algo parece extraño.
Una máquina puede seguir ejecutando mientras sus instrucciones sigan siendo técnicamente válidas.
Una empresa tradicional puede tener tiempo para detectar un problema.
Una empresa automatizada puede consumir ese tiempo en segundos.
Por eso, al digitalizar, no basta con trasladar las reglas actuales hacia un sistema.
Hay que rediseñar la forma en que se identifican y contienen los errores.
La capacidad de escalar debería venir acompañada por una capacidad equivalente para limitar el daño.
Las implicaciones para otras industrias
Banca
Un modelo puede bloquear automáticamente miles de tarjetas por detectar un patrón equivocado.
El control no consiste solamente en mejorar la precisión.
También en limitar el alcance y permitir una corrección rápida.
Seguros
Una regla automatizada puede rechazar reclamaciones de manera consistente.
Si está mal diseñada, la organización no tendrá cientos de decisiones independientes.
Tendrá un sesgo sistemático convertido en política operativa.
Retail
Un algoritmo puede modificar precios o inventarios en toda una red.
Una mala señal puede producir pérdidas, desabastecimiento o una experiencia incoherente en cuestión de minutos.
Salud
Un sistema puede priorizar pacientes o generar recomendaciones clínicas.
Un error repetido a escala requiere controles mucho más exigentes que una falla aislada.
Recursos humanos
Una herramienta puede descartar miles de candidatos siguiendo un criterio defectuoso.
La velocidad del filtro no vuelve justa la decisión.
Solo vuelve más eficiente su repetición.
Servicio al cliente
Una IA puede ofrecer la misma información incorrecta a miles de usuarios antes de que una persona revise las conversaciones.
En todos estos casos, la automatización no elimina el riesgo.
Cambia su velocidad, su alcance y la dificultad de detectarlo.
Seis preguntas que deberían hacerse los líderes
1. ¿Cuál es el peor resultado que puede producir el sistema?
No el promedio.
El extremo.
2. ¿Cuántas decisiones puede ejecutar antes de que lo detectemos?
La capacidad de daño depende tanto del error como de su velocidad.
3. ¿Existe un límite automático?
No debería depender exclusivamente de que alguien vea un correo.
4. ¿Quién puede detenerlo?
La responsabilidad debe ser explícita.
5. ¿Podemos reversar la decisión?
Un sistema sin capacidad de retroceso convierte cada despliegue en una apuesta.
6. ¿Qué tecnología antigua sigue escondida dentro de la nueva?
La deuda tecnológica no desaparece porque ya nadie la mencione.
La reflexión que me queda
Durante años, la transformación digital se presentó como una forma de acelerar empresas.
Y lo es.
Pero acelerar sin diseñar la capacidad de frenar no es transformación.
Es perder control con mayor eficiencia.
Knight Capital no fue destruida por una tecnología demasiado avanzada.
Fue puesta al borde de desaparecer porque su sistema podía actuar más rápido de lo que la empresa podía entender, decidir y reaccionar.
Creo que ahí está la lección más relevante para los líderes actuales.
A medida que damos más autonomía a la tecnología, el gobierno no puede volverse más liviano.
Tiene que volverse más rápido.
Más claro.
Y mucho más exigente.
Porque el objetivo no es construir sistemas que nunca fallen.
Eso probablemente no existe.
El verdadero objetivo es construir organizaciones capaces de detectar el error, contenerlo y detenerlo antes de que una mala decisión automatizada se convierta en una crisis empresarial.